Faire parler un logiciel scientifique : un serveur MCP qui explique ses propres paramètres
Voyez la documentation de votre logiciel scientifique comme un wiki interactif. Un serveur MCP qui transforme des centaines de paramètres de configuration complexes en réponses en langage naturel pour les chercheurs et les ingénieurs de la communauté.
Note de recherche · 16 septembre 2026 · 5 min de lecture
Le problème silencieux du logiciel
Derrière chaque application scientifique complexe se cache un labyrinthe de paramètres de configuration — souvent compris par une poignée de développeurs principaux seulement. C’est particulièrement vrai pour le DDF Pipeline, un logiciel d’auto-calibration et d’imagerie conçu pour le radiotélescope LOFAR (Low Frequency Array). Une seule exécution y mobilise des centaines de paramètres, et en modifier un peut changer des semaines de coûts de calcul ou le résultat scientifique final.
Le code source du DDF Pipeline — aujourd’hui, le seul endroit où réside réellement la signification de ces centaines de paramètres.
Pour les développeurs qui maintiennent le logiciel, ces réglages sont des compagnons familiers. Pour la communauté qui l’utilise, ils sont un obstacle. La « bonne » configuration n’est jamais figée : elle dépend du volume des données d’entrée, du système de calcul qui effectuera le traitement et, surtout, des besoins propres à l’utilisateur. La documentation seule ne peut pas saisir ce contexte. Résultat : cette connaissance critique quitte rarement le code source — github.com/mhardcastle/ddf-pipeline — ce qui laisse un logiciel puissant inaccessible à ceux qui en ont le plus besoin.
Notre approche renverse la perspective. Plutôt que de demander aux utilisateurs de mémoriser des centaines de réglages, nous construisons une interface conversationnelle pour le code lui-même. Nous structurons l’espace des paramètres de l’application en une base de connaissances interrogeable, nous la vectorisons, et nous l’exposons par un serveur MCP (Model Context Protocol). Le logiciel cesse d’être un outil muet pour devenir un assistant capable de s’expliquer, auquel les chercheurs peuvent simplement poser la question.
Le cas d’étude : ce que les paramètres commandent réellement
Le DDF Pipeline transforme les observations de LOFAR en relevés du ciel à grand champ. Ses sorties sont les images qui illustrent les articles d’astronomie — et chacune porte l’empreinte des décisions prises en amont sur les paramètres : échelle de pixels, faisceau de restauration, masquage, compression, allocation de processeurs. Les figures ci-dessous proviennent de LoTSS-DR3, une publication de données produite avec le logiciel même dont nous voulons expliquer les paramètres.
En haut : reprojection des images mosaïques de LoTSS-DR3. En bas : l’image RMS correspondante. Les contours jaunes et bleus délimitent les zones LoTSS-DR1 et LoTSS-DR2, soit respectivement 2 % et 27 % du ciel boréal ; le contour noir montre la couverture de LoTSS-DR3, 88 %. Les petits points gris marquent les 3168 pointés LoTSS, dont 2551 figurent dans cette publication. Source : LoTSS Data Release 3
Exemple de région de 45 deg² du ciel extragalactique issu de LoTSS-DR3 — typiquement environ 30 000 sources détectées au-dessus de 4,5×RMS. On y remarque les radiogalaxies NGC 315 (en bas) et 3C 31 (en bas au centre-gauche), ainsi que la galaxie spirale M 31 (en haut).
Région du plan galactique où la densité de restes de supernova connus est la plus élevée dans LoTSS-DR3 : 190 deg² centrés sur une longitude galactique de 43,5°, incluant G054.4-00.3, G049.2-00.7, G043.9+01.6, G039.7-02.0 et G034.7-00.4.
Ces images sont l’enjeu. Chaque pixel y est conditionné par des paramètres que seuls quelques mainteneurs maîtrisent aujourd’hui entièrement.
La solution : donner une voix au logiciel
Comment apprendre un logiciel à une intelligence artificielle ? Nous ne lui donnons pas simplement du code brut. Nous construisons une carte de connaissances structurée (ou ontologie) de l’espace des paramètres. Voyez cela comme offrir à l’IA une table des matières précise et un glossaire technique du logiciel. Chaque réponse s’appuie ainsi sur la base de code réelle, ce qui l’empêche d’inventer un paramètre qui n’existe pas.
Première étape — structurer la connaissance
Construire cette carte structurée est un exercice multidisciplinaire. Nous travaillons avec les développeurs pour représenter l’application fidèlement, et avec les utilisateurs finaux pour qu’elle reste lisible. L’information utile est extraite de la base de code puis convertie dans un format normalisé (Turtle/TTL) que les machines savent comprendre.
Visualisation de la structure de connaissances du DDF Pipeline : paramètres regroupés en sections, avec leurs types de données, valeurs par défaut, unités et descriptions.
Ces données structurées deviennent ensuite une base de données vectorielle — une représentation qu’un modèle de plongement léger (ici all-MiniLM-L6-v2) sait interroger en langage naturel.
Deuxième étape — l’exposer par MCP
MCP, le Model Context Protocol, est le standard ouvert qui permet à des assistants comme Claude Code et OpenCode de se connecter à des outils et à des sources de données externes. Il devient le pont entre les chercheurs et cette base de connaissances : le serveur héberge le modèle de plongement, dialogue avec la base de données et expose une API REST qui répond à des questions en langage naturel avec les principaux nœuds de la structure.
La documentation d’API du serveur MCP : interroger la base de connaissances en langage naturel, recevoir en retour des nœuds structurés.
Demandez « comment changer la taille de l’image en pixels ? » et le serveur répond par des nœuds classés, issus de la structure :
- image.imsize — section image, type de donnée int, défaut 20000, « taille de l’image en pixels », unité pixel.
- image.cellsize — type de donnée float, défaut 1.5, « taille du pixel en arcsec », unité arcsec.
- machine.NCPU_DDF — « nombre de processeurs à utiliser pour DDF », sélectionné automatiquement si laissé vide.
- masking.tgss_radius — « rayon du masque TGSS en pixels », défaut 8.0, unité pixel.
Aucune approximation et aucun paramètre inventé : chaque réponse est ancrée dans la base de code réelle, par cette connaissance structurée.
Troisième étape — une interface conversationnelle souveraine
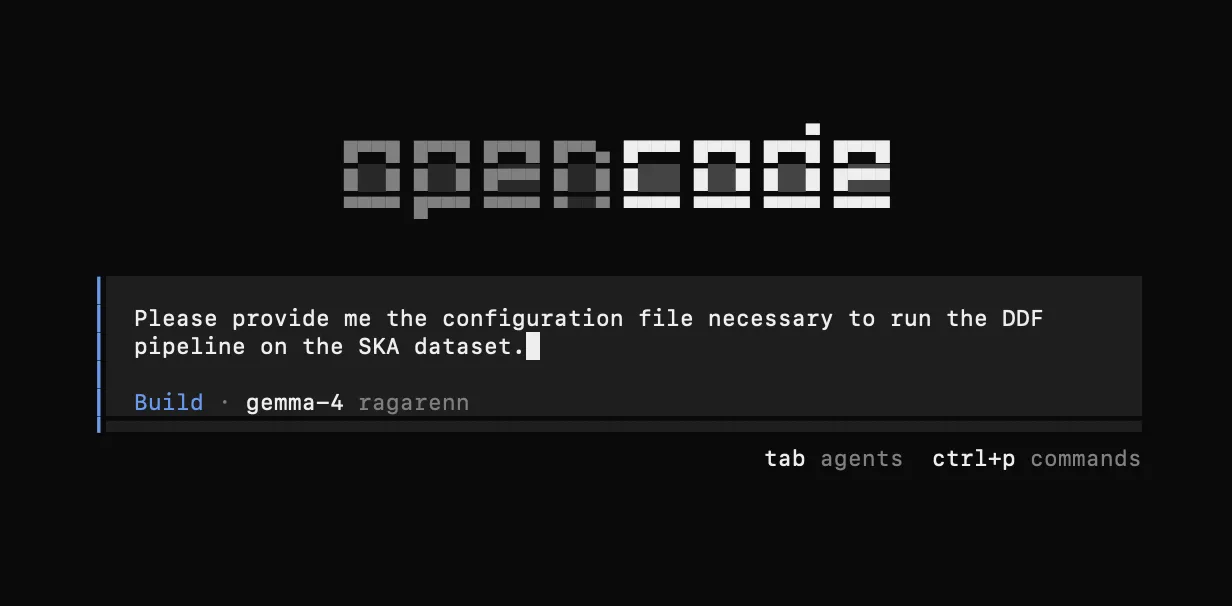
La dernière pièce est l’interface où les chercheurs posent réellement leurs questions. Nous utilisons Ragarenn, une plateforme souveraine hébergeant des grands modèles de langue accessibles par la fédération d’identité eduGAIN — un dispositif pensé pour la confidentialité des données, où rien ne sort d’un périmètre de confiance. Elle expose une API compatible avec le standard d’OpenAI, et nous connectons OpenCode (ou Claude Code) à la fois au modèle et au serveur MCP, pour que la conversation ait lieu dans l’interface de développement que les chercheurs utilisent déjà.
Le résultat : de la documentation au dialogue
Connectez le serveur MCP à l’interface de votre choix et le logiciel finit par répondre de lui-même. Sa force décisive est la modularité.
Vous pouvez fonctionner en mode strict, où le modèle ne répond qu’à partir des informations réelles contenues dans la base de connaissances structurée. Dans ce mode, si un paramètre n’y est pas défini, l’IA ne l’inventera pas : chaque paramètre qu’elle mentionne existe vraiment dans le code.
Vous pouvez aussi enrichir ces réponses ancrées avec un modèle connecté au web, pour y ajouter un contexte externe (par exemple les bonnes pratiques de projets similaires). Les deux modes partagent la même garantie essentielle : la source de vérité est le logiciel lui-même, pas les données d’entraînement de l’IA.
La documentation suppose un lecteur prêt à creuser des pages de texte. Ce système suppose une conversation. En exposant l’espace caché des paramètres d’un logiciel scientifique comme une matière qu’une IA peut lire et expliquer, nous transformons un outil muet en un collègue qui connaît la base de code — et laissons les scientifiques regarder le ciel plutôt que les paramètres.