Astronomie exascale contre cybersécurité : ouvrir les supercalculateurs français à la communauté radioastronomique
Comment un modèle d’accès par service peut ouvrir les supercalculateurs nationaux français à la radioastronomie sans compromettre la cybersécurité.
Publication · 13 septembre 2026 · 19 min de lecture
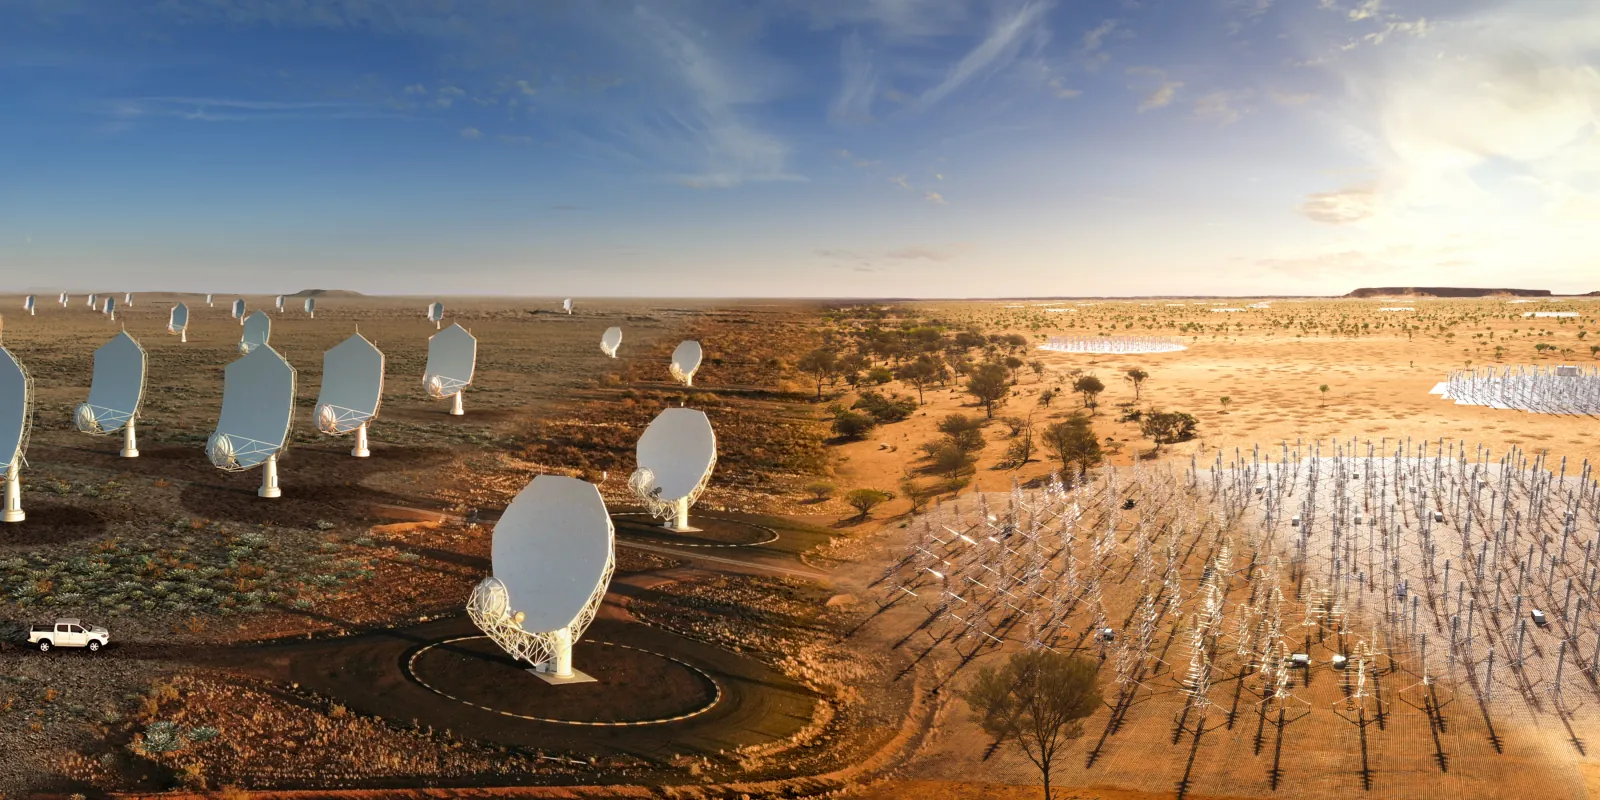
Les radiotélescopes de nouvelle génération, comme le Square Kilometre Array (SKA) [1], produiront des volumes de données exascale qu’aucune grappe locale ne peut absorber. Les traiter exige les architectures parallèles des systèmes nationaux de calcul haute performance (HPC) — et en France, cela signifie les machines coordonnées par GENCI [2] : Adastra au CINES [3], Jean Zay à l’IDRIS [4] et Joliot-Curie au TGCC [5], où le premier supercalculateur exascale français, Alice Recoque, est en cours d’installation.
Le radiotélescope Square Kilometre Array. Crédit : SKAO.
Pour la communauté de la radioastronomie, l’accès à ces machines est bloqué — non par un manque de matériel, mais par un conflit systémique entre la collaboration scientifique et la sécurité nationale. C’est la tension que le travail présenté aux ateliers SC26 entreprend de résoudre : comment permettre à une communauté scientifique de partager une application commune sur les systèmes français de calcul intensif sans enfreindre les règles de responsabilité sur lesquelles ces systèmes reposent.
Le problème n’est pas nouveau. Le Low-Frequency Array (LOFAR) [6] est un réseau européen de radiotélescopes et un précurseur du SKA ; la plateforme LOFAR as a service [7] a démontré la viabilité d’une approche par portail pour l’accès à la demande aux ressources de calcul. Elle permet à la communauté radioastronomique de traiter des données LOFAR par des workflows dédiés, déployés sur des infrastructures de données et de calcul distribuées co-localisées avec les sites de l’archive à long terme de LOFAR, dont SURFsara, l’e-infrastructure nationale néerlandaise [8]. Mais ce modèle a été conçu pour des environnements de grille et ne tenait pas compte des exigences de responsabilité imposées par la réglementation de cybersécurité liée au statut ZRR.
Des travaux empiriques récents [9] identifient les obstacles à l’usage du calcul intensif en radioastronomie — accessibilité limitée, systèmes hétérogènes, lacunes dans l’expertise du calcul avancé et complexité logicielle croissante. Bien que cette étude porte sur le calcul commercial dans un contexte australien, ces obstacles valent aussi pour les infrastructures nationales financées publiquement ; et dans l’écosystème français, les règles de cybersécurité supplémentaires imposées par la ZRR creusent encore l’écart entre la pratique de la radioastronomie et les modèles d’exploitation du calcul intensif.
La friction : la science face à la ZRR
En France, parce que les supercalculateurs sont classés actifs stratégiques nationaux, les centres de calcul qui les hébergent opèrent dans le cadre français de protection du potentiel scientifique et technique de la Nation (PPST) [10]. Établi par la réglementation française et détaillé dans des recommandations publiées par l’ANSSI [11], ce cadre vise à prévenir la perte, le sabotage ou l’appropriation de connaissances et de technologies sensibles par des puissances étrangères ou des acteurs malveillants. Les règles d’accès de GENCI [12] précisent comment ces exigences se traduisent dans les conditions générales d’accès aux ressources nationales de calcul intensif.
Pour appliquer le PPST, un centre de calcul — ou une partie de son infrastructure — est classé zone à régime restrictif (ZRR) par arrêté ministériel [13]. La ZRR place des barrières d’accès physiques et logiques autour des ressources sensibles et impose un ensemble de restrictions opérationnelles à leur usage :
- Accès nominatif — l’accès est accordé individuellement à une personne nommée, ce qui signifie que chaque utilisateur du calcul intensif doit déployer, configurer et maintenir sa propre pile applicative.
- Responsabilité personnelle — l’accès est lié à une personne précise, si bien qu’un usage délégué ou partagé d’un même compte est incompatible avec le régime.
- Traçabilité — les accès physiques et logiques, ainsi que toute circulation à l’intérieur de la ZRR, doivent être réglementés et tracés.
- Transferts de données contrôlés — la divulgation ou le transfert d’informations à des tiers non autorisés doit être évalué et traçable.
À ces contraintes réglementaires s’ajoutent les contraintes ordinaires des supercalculateurs partagés : l’ordonnancement SLURM [14], des limites de temps d’exécution de 24 heures sur Adastra, 100 heures sur Jean Zay et 72 heures sur Joliot-Curie, et un accès à Internet restreint aux nœuds de connexion. Ensemble, elles rendent les applications portées par la communauté — un workflow unique, maintenu par quelques experts et utilisé par des dizaines de chercheurs — très difficiles à exploiter sur les machines françaises.
Le résultat est un cauchemar de passage à l’échelle. Là où un modèle communautaire repose sur quelques experts pour maintenir un workflow destiné à des dizaines de chercheurs, la règle du nominatif oblige chaque chercheur à déployer, configurer et maintenir lui-même toute la pile sur chaque supercalculateur qu’il utilise. Chaque centre exigeant sa propre inscription nominative, la charge se multiplie à chaque machine.
Le supercalculateur Jean Zay. Crédit : CNRS, Cyril Frésillon.
Pourquoi les solutions existantes ne conviennent pas
Plusieurs familles d’outils répondent déjà à une partie de ce problème, mais aucune ne satisfait l’exigence de responsabilité personnelle de la ZRR tout en servant une communauté entière :
- Les systèmes de gestion de workflows comme Pegasus [15], Nextflow [16] ou Snakemake [17] orchestrent des graphes acycliques dirigés sur le nuage et le calcul intensif, et savent soumettre via un ordonnanceur local. Mais ils restent, par nature, des moteurs par utilisateur : chacun installe, configure et maintient sa propre instance sous un compte nominatif, et le déploiement n’est jamais exposé comme un service partagé et exploité.
- Les portails web et les passerelles scientifiques [18], [19] masquent la complexité du calcul intensif derrière une interface et satisfont l’accès nominatif en associant chaque utilisateur du portail à son propre compte — mais ils ne suppriment pas la charge opérationnelle : chaque utilisateur déploie et maintient toujours la pile applicative scientifique.
- Les intergiciels de l’ère des grilles comme GlideinWMS [20], PanDA [21] ou DIRAC [22] combinent une exécution pilotée par des pilotes avec des identités d’organisation virtuelle — des certificats mandataires à durée limitée émis par VOMS [23]. L’incompatibilité avec la ZRR tient à l’identité exécutante — une accréditation collective — et non au mode de distribution par tirage lui-même.
- Les couches d’accès programmatique comme Globus Compute (à l’origine funcX) [24] et FirecREST [25] sont les plus proches de notre approche : elles exposent des API pour soumettre et surveiller des tâches sur des supercalculateurs distants. Dans leurs déploiements standard, cependant, elles authentifient les utilisateurs individuellement et associent chaque tâche à l’identité de calcul de l’utilisateur demandeur — et n’offrent aucun catalogue centralisé d’applications scientifiques validées, exposé comme un service communautaire.
La ZRR exige la responsabilité personnelle et la traçabilité de chaque action effectuée sur le système. La règle selon laquelle l’utilisateur et l’exécutant doivent être la même identité est une façon de satisfaire cette exigence — et elle interdit aujourd’hui à un compte de calcul intensif d’exécuter des tâches pour le compte d’un tiers.
La « question Globus » : pourquoi ne pas utiliser les standards existants ?
Pour de nombreux chercheurs, surtout aux États-Unis, Globus est la référence pour le transfert de données et la gestion des identités en calcul intensif, et il semble être la réponse évidente. Alors pourquoi Globus n’est-il pas utilisé dans les centres français soumis au PPST et au régime ZRR ?
La réponse tient à l’externalisation des métadonnées opérationnelles.
- L’infrastructure : les services Globus sont hébergés sur Amazon Web Services et exploités par Globus, tandis que les points de stockage et de calcul restent exploités par les organisations abonnées.
- Ce qui est stocké [26] : les fichiers de recherche ne sont pas partagés avec Globus, mais ses services conservent des informations liées aux tâches, des accréditations temporaires, des noms de fichiers et des chemins de répertoires.
- Le mandat français : tout accès logique à des informations protégées par le régime PPST est strictement soumis à autorisation du ministère de tutelle. Externaliser ces métadonnées opérationnelles peut soulever des questions de conformité PPST et ZRR — y compris une exposition potentielle à des procédures judiciaires américaines au titre du 18 U.S.C. § 2713 [27]. Au moment de la rédaction, nous n’avons trouvé aucun point de terminaison Globus Compute exploité par un centre national français de calcul intensif qui soit documenté publiquement.
En bref : là où Globus offre la commodité d’une orchestration dans le nuage, la ZRR exige un contrôle souverain sur les données opérationnelles. C’est précisément pourquoi notre approche ne repose pas sur Globus : elle s’appuie sur un cadre existant pour les applications scientifiques comme service, composé de microservices applicatifs (AM) pour le déploiement des applications et de tampons éphémères (EB) pour la logistique de données transitoires — offrant des fonctionnalités comparables à Globus tout en restant conforme au droit français de sécurité nationale.
La solution : les applications scientifiques comme service
Pour combler cet écart, nous proposons de découpler l’identité de l’utilisateur de l’identité de l’exécutant, dans un cadre qui expose les applications scientifiques comme un service [28]. Plutôt que de forcer chaque astronome à devenir administrateur de système de calcul intensif, nous mutualisons l’usage des supercalculateurs autour d’un petit ensemble de rôles précis :
- Les utilisateurs sont identifiés par une fédération d’authentification reconnue (par exemple EduGAIN), peuvent être temporaires et n’ont pas besoin de connaître les systèmes de calcul intensif.
- Les mainteneurs sont des experts du calcul intensif issus de la communauté scientifique : ils déploient les applications scientifiques et leur environnement d’exécution sur un supercalculateur cible et assument la responsabilité opérationnelle des tâches qui y sont exécutées. Leur responsabilité est découplée du développement : ils n’ont pas besoin d’appartenir au projet qui écrit le logiciel, mais ils valident chaque version qu’ils déploient.
- Un compte de service nommé est un compte de calcul intensif détenu par un mainteneur, par lequel les utilisateurs soumettent des tâches sans détenir d’accréditation individuelle. Le limiter à une seule application scientifique prédéfinie simplifie l’audit pour le service de cybersécurité du centre.
- Une liste blanche d’utilisateurs est définie pour chaque compte de service nommé. Tenue par le mainteneur, elle recense les utilisateurs autorisés à utiliser les ressources du compte, ce qui satisfait l’exigence de la ZRR en matière de transferts de données contrôlés.
- Une tâche est la soumission de données à traiter avec un logiciel fixe et préinstallé. Une fois soumise, elle est tirée et exécutée automatiquement par l’environnement d’exécution du mainteneur, ce qui attribue la responsabilité de l’exécution au mainteneur et satisfait ainsi l’exigence de responsabilité personnelle de la ZRR.
La dérogation nécessaire est étroite : autoriser le mainteneur à exécuter des tâches qui traitent des données soumises par un tiers, ce tiers étant identifié par une fédération d’authentification. Cette proposition est actuellement en discussion avec les acteurs français de la sécurité du calcul intensif.
L’architecture : comment cela fonctionne
Le cadre constitue un point d’entrée unique pour lancer des tâches d’applications scientifiques sur les supercalculateurs, sans accès direct aux centres sous-jacents. Il enveloppe des workflows complexes dans un service fluide :
- Microservices applicatifs (AM) [29] — le catalogue des applications scientifiques disponibles, exposées comme des microservices. AM orchestre l’exécution via des entités de tâche et d’environnement d’exécution ; la soumission et l’exécution étant découplées, les utilisateurs n’ont pas besoin d’une connexion permanente, ce qui permet une expérience de type « lancer et oublier » pour des tâches qui peuvent durer plusieurs jours.
- Tampons éphémères (EB) [30] — une couche de logistique de données transitoire offrant un stockage temporaire et un point d’échange entre les utilisateurs et les systèmes de calcul intensif. Ils ne sont pas obligatoires, mais facilitent les transferts et sont accessibles avec une simple identité d’utilisateur.
- L’exécutant — un script Python (runner.py), lancé par un mainteneur, qui interroge périodiquement AM pour les tâches en attente et les exécute sur le système cible par SSH [31], [32]. Cette conception par tirage — plutôt qu’un service web poussant les tâches dans la zone sécurisée — satisfait les exigences de responsabilité et de traçabilité, et fait respecter la liste blanche avant toute exécution.
Architecture des applications scientifiques comme service. Chaque acteur opère sous un domaine de gouvernance distinct — les utilisateurs et développeurs sous la politique de leur laboratoire, l’API sous celle de l’IRISA, et les centres de calcul sous leur politique interne et la réglementation ZRR — tandis que les mainteneurs se situent à l’intersection de l’API et de chaque centre.
Le cycle de vie d’une tâche
Du point de vue de l’utilisateur, une tâche globale est un objet unique à suivre de la soumission à l’achèvement :
- Authentification — l’utilisateur s’authentifie auprès de l’API AM et reçoit en retour un client authentifié.
- Choix de l’application — l’utilisateur liste les applications disponibles, éventuellement filtrées par nom, puis demande le contrat de l’application choisie, qui décrit les entrées et sorties attendues.
- Soumission d’une tâche globale — à partir de ce contrat, l’utilisateur prépare la tâche localement, décrit ses entrées en JSON et la soumet. L’API l’enregistre pour exécution.
- Boucle de suivi — l’utilisateur interroge l’état de la tâche globale après la soumission, sans attendre le début de l’exécution.
- Tâche de l’exécutant — pendant ce temps, l’exécutant du mainteneur prend la tâche en attente, la marque comme en cours, prépare le répertoire de travail, met en place les entrées et soumet une tâche à SLURM.
- Tâche SLURM — la tâche globale et la tâche SLURM sont distinctes : la première est gérée par l’API AM, la seconde par l’ordonnanceur qui exécute le calcul. L’exécutant surveille la tâche SLURM jusqu’à sa fin, puis collecte les résultats.
- Récupération des sorties — l’exécutant réécrit les résultats collectés dans l’API et marque la tâche globale comme achevée ; l’utilisateur télécharge alors les sorties par l’API, sans jamais se connecter au système de calcul.
Les quatre durées de vie sont imbriquées : la tâche SLURM s’exécute dans la tâche de l’exécutant, elle-même dans la tâche globale, que l’utilisateur suit.
Preuve de concept : le DDF Pipeline sur Jean Zay
Nous avons instancié cette architecture avec le DDF Pipeline [33], [34], une application de radioastronomie portée par la communauté, dont l’empreinte mémoire, les exécutions de plusieurs jours et la dépendance à des jeux de données LOFAR externes en font un cas de test exigeant pour les supercalculateurs français soumis au régime ZRR.
Le DDF Pipeline est une application composite intégrant DDFacet [35], un logiciel d’imagerie par facettes dépendant de la direction, et killMS [36], un logiciel de calibration pour l’interférométrie radio. Elle traite des Measurement Sets (MS), un format normalisé pour les visibilités d’interféromètre, et produit des images du ciel au format FITS. À l’origine application à mémoire partagée sur processeurs, elle requiert environ 400 Go de RAM pour traiter des jeux de données LOFAR : une exécution représentative sur 24 fichiers MS d’entrée — 38,72 Go compressés — a produit 594 Go de sortie après 68,8 heures sur un seul nœud [37].
La mémoire par nœud détermine ce qui peut tourner où : Adastra [38] offre 768 Go par nœud et convient bien au pipeline, Jean Zay [39] dispose de 192 Go par nœud et impose de limiter la taille de l’image du ciel générée (les partitions GPU dotées d’au moins 512 Go peuvent aussi être utilisées), et Joliot-Curie [40] offre 228 Go par nœud — avec seulement 7 nœuds à grande mémoire suffisants. Une configuration qui tient sur une machine peut être impossible sur une autre.
Pour nous préparer aux volumes de données du SKA, nous avons co-développé une version parallèle du DDF Pipeline avec des partenaires du laboratoire commun ECLAT [41], en intégrant la parallélisation multi-cœur et multi-nœud de DDFacet [42] à une implémentation parallèle de killMS. C’est la version utilisée pour les résultats ci-dessous.
Le workflow du DDF Pipeline — trois étapes, chacune exposée comme un microservice distinct.
Une expérience complète s’exprime en trois étapes, chacune étant un microservice spécifique :
- Télécharger les données — les entrées sont des fichiers MS donnés par chemin local ou URL, un supercalculateur cible et son identifiant. Le microservice vérifie la compatibilité avec le supercalculateur en s’assurant que le domaine de l’URL figure dans la liste blanche attribuée au compte de service nommé ; les chemins locaux sont mis en place par les tampons éphémères. La sortie est un identifiant de tâche globale.
- Exécuter le DDF Pipeline — les entrées sont un fichier de configuration ou des options précises (par exemple la taille de l’image) et l’identifiant de tâche globale. Le microservice valide la configuration et l’accès aux données d’entrée, prépare le répertoire d’exécution et soumet une tâche à SLURM, en renvoyant l’identifiant de tâche globale pour que l’utilisateur puisse suivre son état.
- Déposer les résultats — les entrées sont la destination (chemin local ou URL) et l’identifiant de tâche globale. Le microservice dépose les données par les tampons éphémères pour un chemin local, ou par l’API pour un dépôt distant.
Les résultats
Le workflow a été mis à l’épreuve sur le supercalculateur Jean Zay pour valider l’architecture. Nous avons mesuré trois choses : où les données peuvent résider, comment le pipeline passe à l’échelle, et ce que coûte la couche de service.
- Accès aux données — pour le jeu de données d’intégration de 8 heures LOFAR LoTSS L234026, SURFsara a offert le meilleur débit de téléchargement moyen (137,9 Mo/s, mais avec la variabilité la plus forte), devant EOSC [43] (51,85 Mo/s) et CNRS Drive (52,36 Mo/s). Le dépôt a favorisé EOSC (28,73 Mo/s, coefficient de variation 34,3 %) face à CNRS Drive (13,81 Mo/s, 84,7 %), ce qui fait de SURFsara et EOSC les points de terminaison viables pour cette expérience.
- Passage à l’échelle — le temps écoulé est passé de 68,8 heures sur 1 nœud à 8,7 heures sur 24 nœuds (≈7,9× d’accélération), en passant par 14,4 heures sur 6 nœuds et 10,2 heures sur 12 nœuds. L’utilisation moyenne des processeurs a chuté de 63,5 % à 31 %, principalement parce que les étapes de déconvolution de DDFacet, non parallélisées, limitent l’efficacité du passage à l’échelle — leur parallélisation est en cours.
- Surcoût du service — la soumission d’une tâche par l’API n’a ajouté que 0,25 à 0,96 seconde pour des configurations de 0 (référence), 1 et 5 tampons éphémères. C’est négligeable face à des exécutions qui vont de plusieurs heures à plusieurs jours.
Diagramme de séquence de la soumission d’une tâche. Les quatre durées de vie sont imbriquées : la tâche SLURM (gris) s’exécute dans la tâche de l’exécutant (jaune), elle-même dans la tâche globale (bleu) suivie par l’utilisateur (violet).
La suite : au-delà de la preuve de concept
La limitation centrale de ce travail n’est pas technique mais réglementaire : le découplage proposé exige une dérogation formelle à une interdiction explicite de la ZRR, et son acceptation par les autorités françaises de sécurité du calcul intensif reste la prochaine étape vers un déploiement complet.
Exploiter le DDF Pipeline comme un service sur une infrastructure nationale a également fait apparaître trois conséquences pratiques :
- Qualité de service — SLURM priorise les comptes dont l’usage récent est faible. Tous les utilisateurs accédant aux ressources par un compte unique, cela crée des délais d’allocation importants : la politique de partage équitable du compte de service nommé devra donc être adaptée.
- Stockage — une seule exécution génère des centaines de gigaoctets, alors que les quotas des supercalculateurs sont limités. Les résultats doivent être transférés vers une source externe et les répertoires de travail nettoyés après chaque exécution, ce qui limite aussi le nombre de tâches menées en parallèle et motive la répartition des tâches entre plusieurs systèmes de calcul.
- Reproductibilité — la reproductibilité étape par étape est irréaliste pour des pipelines qui produisent des centaines de gigaoctets de produits intermédiaires par exécution. Nous visons plutôt la reproductibilité du workflow entier, en conservant les références des entrées, les paramètres d’exécution et les spécifications de l’environnement.
Des exécutions du DDF Pipeline entre centres, entre Jean Zay et Adastra, ont été validées, ce qui motive l’intégration future d’un déploiement inter-sites [44] dans le cadre EB/AM. Le modèle du compte de service nommé reste en discussion avec les acteurs français du calcul intensif, et les travaux à venir étendront le déploiement à d’autres supercalculateurs français — Adastra et Joliot-Curie.
Conclusion
La sécurité devrait être un levier pour la science, pas une barrière. En passant d’un modèle d’« accès utilisateur » à un modèle d’« accès par service » — et en séparant l’identité de l’utilisateur de celle de l’exécutant — nous pouvons concilier les exigences de responsabilité de la ZRR avec la façon dont les communautés scientifiques travaillent réellement, et ouvrir les supercalculateurs français à la communauté de radioastronomie qui en a le plus besoin.
Références
- P. E. Dewdney, P. J. Hall, R. T. Schilizzi, and T. J. L. W. Lazio, “The Square Kilometre Array,” Proc. IEEE, vol. 97, no. 8, pp. 1482–1496, Aug. 2009.
- GENCI, “Grand Equipement National de Calcul Intensif (GENCI).”
- CINES, “Centre Informatique National de l’Enseignement Supérieur (CINES).”
- CNRS, “Institut du Développement et des Ressources en Informatique Scientifique (IDRIS).”
- CEA, “Très Grand Centre de Calcul (TGCC).”
- M. P. van Haarlem, M. W. Wise, A. W. Gunst, G. Heald, J. P. McKean, J. W. T. Hessels, et al., “LOFAR: The LOw-Frequency ARray,” Astron. Astrophys., vol. 556, p. A2, Aug. 2013.
- A. P. Mechev, J. B. R. Oonk, A. Plaat, A. Danezi, and T. W. Shimwell, “Building LOFAR as a Service,” in Proc. Astronomical Data Anal. Softw. Syst. XXVIII (ADASS), vol. 523, San Francisco, CA, USA: Astronomical Society of the Pacific, 2019, p. 677.
- J. Templon and J. Bot, “The Dutch National e-Infrastructure,” in Proc. Int. Symp. Grids Clouds (ISGC 2016), vol. 270, Taipei, Taiwan: SISSA Medialab, Jan. 2017, p. 020.
- I. P. Kemp, S. J. Tingay, S. D. Midgely, and D. A. Mitchell, “Experiences of commercial supercomputing in radio astronomy data processing,” Astron. Comput., vol. 54, p. 101013, Jan. 2026.
- Légifrance, “Protection du Potentiel Scientifique et Technique (PPST),” Décret n° 2024-430 du 14 mai 2024.
- ANSSI, “Protection du Potentiel Scientifique et Technique de la Nation (PPST),” Agence nationale de la sécurité des systèmes d’information.
- GENCI, “Modalités d’accès aux ressources nationales,” Réf. CD230106, version 1.15, May 2023.
- Légifrance, “Zones à Régime Restrictif (ZRR),” Code pénal, Art. R413-5-1, 2025.
- A. B. Yoo, M. A. Jette, and M. Grondona, “SLURM: Simple Linux Utility for Resource Management,” in Proc. Workshop Job Scheduling Strategies for Parallel Processing (JSSPP), vol. 2862, Berlin, Germany: Springer, Jun. 2003, pp. 44–60.
- E. Deelman et al., “The Evolution of the Pegasus Workflow Management Software,” Comput. Sci. Eng., vol. 21, no. 4, pp. 22–36, Jul. 2019.
- P. Di Tommaso, M. Chatzou, E. W. Floden, P. P. Barja, E. Palumbo, and C. Notredame, “Nextflow enables reproducible computational workflows,” Nat. Biotechnol., vol. 35, no. 4, pp. 316–319, Apr. 2017.
- J. Köster and S. Rahmann, “Snakemake—a scalable bioinformatics workflow engine,” Bioinformatics, vol. 28, no. 19, pp. 2520–2522, Oct. 2012.
- P. Calegari, M. Levrier, and P. Balczynski, “Web Portals for High-performance Computing: A Survey,” ACM Trans. Web, vol. 13, no. 1, pp. 5:1–5:36, Feb. 2019.
- M. Barker et al., “The global impact of science gateways, virtual research environments and virtual laboratories,” Future Generation Computer Systems, vol. 95, pp. 240–248, Jun. 2019.
- I. Sfiligoi, “glideinWMS—a generic pilot-based workload management system,” J. Phys.: Conf. Ser., vol. 119, no. 6, p. 062044, Jul. 2008.
- T. Maeno, “PanDA: distributed production and distributed analysis system for ATLAS,” J. Phys.: Conf. Ser., vol. 119, no. 6, p. 062036, Jul. 2008.
- A. Casajus, R. Graciani, S. Paterson, A. Tsaregorodtsev, and LHCb DIRAC Collaboration, “DIRAC pilot framework and the DIRAC Workload Management System,” J. Phys.: Conf. Ser., vol. 219, no. 6, p. 062049, Apr. 2010.
- R. Alfieri et al., “From gridmap-file to VOMS: managing authorization in a Grid environment,” Future Gener. Comput. Syst., vol. 21, no. 4, pp. 549–558, Apr. 2005.
- R. Chard et al., “funcX: A Federated Function Serving Fabric for Science,” in Proc. 29th Int. Symp. High-Perform. Parallel Distrib. Comput. (HPDC ’20), Stockholm, Sweden, Jun. 2020, pp. 65–76.
- F. A. Cruz et al., “FirecREST: a RESTful API to HPC systems,” in Proc. IEEE/ACM Int. Workshop Interoperability Supercomput. Cloud Technol. (SuperCompCloud), Nov. 2020, pp. 21–26.
- Globus, “High Assurance Security Overview,” Globus documentation, University of Chicago.
- U.S. Code, “Required preservation and disclosure of communications and records,” 18 U.S.C. 2713, Legal Information Institute, Cornell Law School, Mar. 2018.
- L. Morin, F. Bodin, and G. Nyastikor, “HPC Software as a Service: A Flexible Approach to Data Logistics,” presented at the 3rd Int. Workshop on Scalable Compute Continuum (WSCC 2025), Dresden, Germany, Aug. 2025.
- L. Morin and G. Nyastikor, “Application Microservices (AM),” Online API documentation.
- L. Morin and G. Nyastikor, “Ephemeral Buffers (EB),” Online API documentation.
- CINES, “Adastra supercomputer user documentation.”
- IDRIS, “SSH access to the Jean Zay supercomputer.”
- C. Tasse et al., “The LOFAR Two-meter Sky Survey: Deep Fields Data Release 1 - I. Direction-dependent calibration and imaging,” Astron. Astrophys., vol. 648, p. A1, Apr. 2021.
- M. Hardcastle, T. Shimwell, C. Tasse, and W. Williams, “DDF Pipeline source code,” GitHub repository.
- C. Tasse, “DDFacet source code: A facet-based radio imaging package,” GitHub repository.
- C. Tasse, “killMS source code: A Wirtinger-based direction-dependent radio interferometric calibration package,” GitHub repository.
- M. Certenais, F. Bodin, and L. Morin, “A description of the radio astronomy data processing tool DDF Pipeline,” arXiv:2509.03075, Sep. 2025.
- CINES, “Adastra supercomputer architecture.”
- IDRIS-CNRS, “Jean Zay supercomputer architecture.”
- TGCC-CEA, “TGCC Public Documentation,” Sep. 2026.
- ECLAT, “Extreme Computing Lab for Astronomical Telescopes (ECLAT).”
- N. Monnier et al., “Multi-core multi-node parallelization of the radio interferometric imaging pipeline DDFacet,” in Proc. IEEE Workshop Signal Process. Syst. (SiPS), Rennes, France, Nov. 2022, pp. 1–6.
- P. Budroni, J.-C. Burgelman, and M. Schouppe, “Architectures of Knowledge: The European Open Science Cloud,” ABI Technik, vol. 39, no. 2, pp. 130–141, Jul. 2019.
- K. B. Antypas et al., “Enabling discovery data science through cross-facility workflows,” in Proc. IEEE Int. Conf. Big Data (Big Data), Orlando, FL, USA, Dec. 2021, pp. 3671–3680.