Comment j’ai créé un laboratoire d’IA pour lancer mon coach de course virtuel open source
Dans ce blog de projet personnel, Mathis Certenais raconte comment une blessure au genou et un dossier de fichiers GPS sont devenus un coach de course virtuel open source — et pourquoi le véritable produit est la méthode derrière lui : un orchestrateur, huit agents spécialisés et une suite de tests qui refuse de laisser un chiffre mentir.
Projet personnel · 26 octobre 2026 · 7 min de lecture
L’entretien
Vous êtes d’abord coureur. Où cela commence-t-il ?
Je suis un coureur amateur. J’ai commencé comme la plupart des gens : la course est devenue à la mode, alors j’ai essayé. Ce qui m’a accroché, c’est son côté pratique — on met ses chaussures, on passe la porte et on court.
J’ai augmenté la distance progressivement, puis je me suis heurté à un mur à 10 km : la douleur. Un kinésithérapeute pour des exercices, une radiographie, une échographie, un médecin du sport, et enfin un diagnostic — le syndrome fémoro-patellaire. Rien de dramatique, mais assez pour comprendre qu’il fallait que je fasse attention à ce que je faisais.
Vous avez donc commencé à collecter des données. Qu’est-ce qui n’a pas marché ?
J’ai commencé à enregistrer mes courses avec OpenTracks, un traqueur sportif mobile open source qui respecte votre vie privée. Les fichiers se sont accumulés, et je n’avais ni le temps ni les connaissances pour les analyser.
Un fichier GPS n’est pas une connaissance. C’est le relevé précis de quelque chose que je ne comprenais pas.
Que vouliez-vous à la place ?
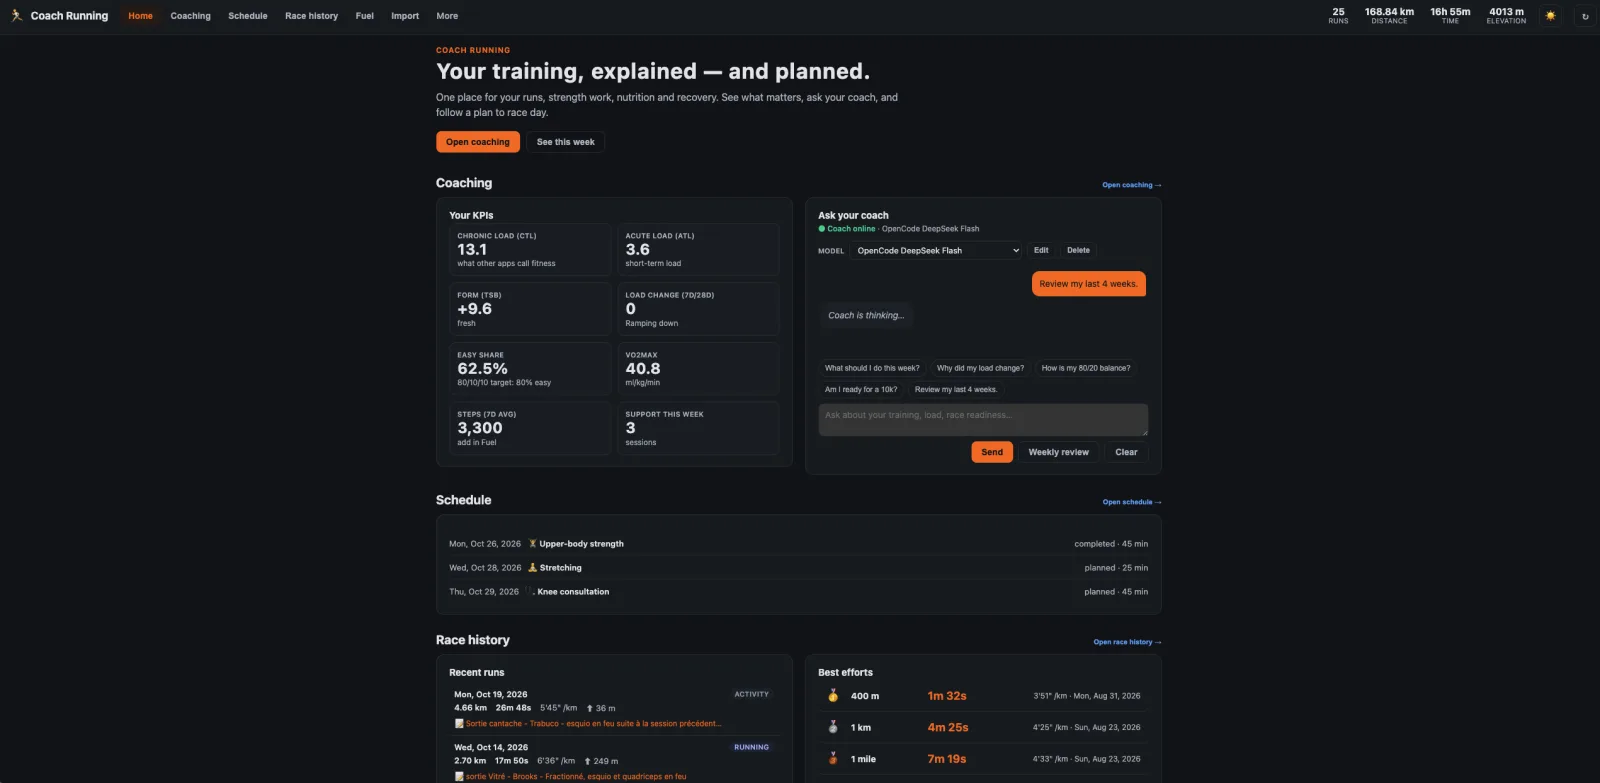
Un coach virtuel appuyé sur la littérature, qui calcule mes propres indicateurs à partir de mes propres données : VO2max, répartition de l’intensité, charge d’entraînement, signaux de blessure. Je l’ai ensuite enrichi avec ce qui entoure réellement une course — la nutrition, un programme d’étirements et de renforcement, et le nombre de pas quotidien, qui compte beaucoup dans mon cas : les journées sédentaires sont exactement celles où le genou proteste.
Et l’IA par-dessus, pour faire parler ces données : stratégie d’entraînement, étirements de préparation à la course, prédictions de temps de course.
Concrètement, que remet le coach à un kinésithérapeute ?
Un rapport exporté, généré localement depuis la base, qui couvre les dix semaines jusqu’au 19 octobre 2026 : 25 courses, 168,8 km, 16 h 55 de temps en mouvement, 4 013 m de dénivelé. Il porte les indicateurs de charge — charge chronique 12,8, charge aiguë 3,0, forme 9,8 —, la répartition de l’intensité face à la cible 80/10/10, ce que j’ai signalé comme douleur, les séances de renforcement et de mobilité avec leur effort perçu, et le kilométrage de chaque paire de chaussures.
C’est tout l’intérêt de l’export. En consultation, j’apporte ce dont je me souviens de la veille, et personne ne se souvient de dix semaines d’entraînement. Le rapport, lui, apporte les chiffres et le ressenti que j’avais consigné séance après séance, sur le moment — pas reconstruit trois semaines plus tard autour d’un genou qui fait mal aujourd’hui. Le kinésithérapeute et moi lisons le même fichier.
Le rapport destiné au kinésithérapeute, du 10 août au 19 octobre 2026, généré le 27 octobre 2026. Il se termine sur la réserve qui compte : corrélation n’est pas causalité — ce sont des motifs à discuter avec un professionnel, pas un diagnostic.
Vous ne cessez de répéter que « le capteur, c’est la montre, le téléphone, c’est le transport, l’ordinateur portable, c’est le cerveau ». Qu’est-ce que cela veut dire ?
C’est l’architecture, en une phrase.
La montre enregistre. Le téléphone déplace le fichier. L’ordinateur portable pense — et il conserve les données. Pas de compte, pas de cloud, pas de télémétrie : l’application tourne sur 127.0.0.1, lit des fichiers dans un dossier et écrit dans une base SQLite à côté.
Je cherchais la performance. Mais la performance commence par l’analyse de ce qui se passe sur le terrain, et cette analyse devait m’appartenir.
Qu’est-ce qu’un « laboratoire d’IA », concrètement ?
Pas un modèle. Une façon de travailler.
L’environnement, c’est OpenCode. Dedans, un orchestrateur me parle, planifie et répartit le travail. Autour, huit spécialistes aux périmètres disjoints : développeur, architecte, UI, contrôle qualité, scientifique, marketing, sécurité, rédaction. Ils chargent les compétences d’ingénierie de mattpocock/skills quand une tâche en réclame une — le questionnement serré avant une décision de conception, le développement piloté par les tests, la revue de code contre un standard écrit.
Ce qui en fait une organisation plutôt qu’une collection de prompts, ce sont les permissions. L’agent qualité ne peut pas modifier de fichier. L’architecte ni le relecteur de sécurité non plus. Un relecteur qui peut corriger ce qu’il trouve cesse d’être un relecteur.
Pourquoi des spécialistes plutôt qu’un seul grand prompt ?
Parce qu’un agent unique fera tout, mal, et ne vous le dira jamais.
Deux agents qui ne se parlent pas produisent deux vocabulaires, deux modèles de données et deux langages visuels. C’est le mode de défaillance que je voulais écarter dès la conception : le scientifique n’est pas d’accord avec le marketing, l’agent qualité n’est pas d’accord avec le développeur, et j’arbitre. Ce désaccord, c’est le produit.
Qu’est-ce qui est open source, et qu’est-ce que vous vendez ?
Le code est sous AGPL-3.0 sur GitHub. Il est libre, il tourne sur votre machine, et il le restera.
Ce que je vends, ce n’est pas le binaire. C’est la capacité de mener une idée jusqu’à une preuve de concept qui fonctionne : l’organisation d’agents, la discipline de recherche, les tests, la documentation, la mise en production. Cette application est l’étude de cas ; votre projet est le suivant.
Comment gérer un laboratoire d’IA sur le plan économique ?
Tout ce que fait un agent coûte du contexte, donc la première décision de gestion n’est pas le choix du modèle. C’est ce qu’on lui met devant les yeux.
Commencez par le prix, car c’est lui qui décide de l’architecture. Sur OpenCode Zen, par million de tokens :
- DeepSeek V4.1 Flash — entrée $0.30, sortie $1.20, lecture du cache $0.006.
- DeepSeek V4 Pro — entrée $1.74, sortie $3.48, lecture du cache $0.145.
Une session réaliste — 40 tours, environ 40k tokens de contexte, 1k de sortie par tour — envoie à peu près 1,6 million de tokens d’entrée :
- Flash — $0.53 sans cache ; $0.10 avec 90 % de cache.
- Pro — $2.92 sans cache ; $0.63 avec 90 % de cache.
Relisez les deux scénarios. Un token d’entrée coûte $0.30 par million quand le modèle ne l’a jamais vu, et $0.006 quand il vient du cache : cinquante fois moins. Le chiffre qui compte n’est donc pas le prix du modèle, c’est le nombre de défauts de cache. Tout ce qui réécrit le début de la conversation — modifier le prompt système, réordonner les instructions du projet, recharger une compétence en cours de tâche — jette le cache et vous fait passer, sans bruit, du scénario avec cache à celui sans cache.
La règle est donc : Flash pour l’exécutant, Pro pour l’architecte. Dix cents pour la session qui écrit les tests, soixante pour celle qui décide de la structure.
La réponse à « comment faites-vous tourner tout ça » tient en quatre outils, chacun faisant une seule chose.
herdr est le bâtiment. Un multiplexeur de terminal conçu pour les agents : des panneaux, des onglets, des sessions, un worktree git par expérience, et une barre latérale qui indique quel agent travaille, attend ou est bloqué. Il ne fait pas tourner l’IA ; il lui donne un endroit où tourner.
OpenCode, c’est l’équipe. Un orchestrateur et huit sous-agents natifs — le développeur, l’architecte, l’UI, la qualité, le scientifique, le marketing, la sécurité et la rédaction décrits plus haut. C’est là que le travail se décompose.
Pi est le prestataire seul. Un harnais minimal : prompt système court, peu d’outils, pas de sous-agents, peu coûteux à exécuter. Ce minimalisme est le but — c’est là que je veux une tâche précise et bornée, et rien d’autre dans le contexte.
Fresh est mon bureau. Un éditeur en terminal, dans un panneau à côté des agents, pour lire le diff et corriger à la main.
Voilà tout le modèle de gestion : dépenser le modèle cher sur les décisions, le bon marché sur l’exécution, et garder le contexte assez stable pour que le cache continue de payer. Le reste, c’est de l’ergonomie.
Et ensuite ?
Deux choses, dans l’ordre.
Validation. Le module de blessure a un taux de base, un export pour un kinésithérapeute et un endroit où consigner son verdict — mais il n’a jamais été confronté à un épisode réel ni à la lecture d’un clinicien. C’est la prochaine heure de travail, et ce n’est pas du code.
Portée. L’application est en import seul par conception : la montre enregistre, l’application pense. Faire disparaître ce transport n’est pas vraiment un problème de fonctionnalité. C’est le problème sur lequel je travaille tous les jours dans ma thèse — la logistique des données : les données sont produites en périphérie, elles doivent rejoindre un endroit où elles peuvent être traitées, sans autorité centrale, sans duplication silencieuse et avec une réponse claire à la question de qui possède la copie. Ici, l’instrument est une montre et le calcul un ordinateur portable. À l’IRISA, c’est un radiotélescope et un supercalculateur, et les questions sont identiques : qu’est-ce qui se déplace, quand se déplace-t-il, qu’est-ce qui est copié deux fois, et que se passe-t-il quand un transfert meurt en route.
Le reste est déjà dans le dépôt : un coach de course virtuel open source, 324 tests, sept décisions d’architecture, dix notes de recherche avec citations, et onze outils en lecture seule que le coach peut appeler pour répondre à des questions sur mes propres données.
C’est la direction que je veux donner à ce projet — pas plus de fonctionnalités, mais le même raisonnement logistique appliqué à plus petite échelle, à ciel ouvert. La recherche derrière est ici : mathiscertenais.com/research.
Sources
- Le projet sur GitHub
- Mon profil de coureur
- Les compétences d’ingénierie utilisées pour le construire